




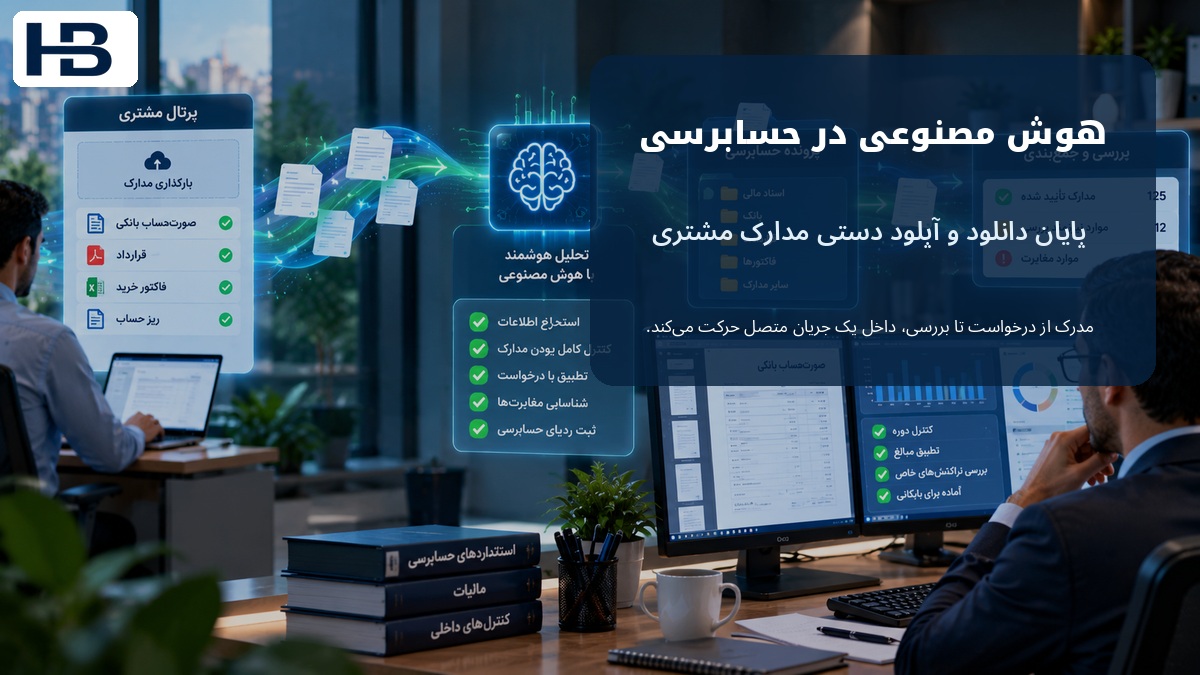
هوش مصنوعی در حسابرسی چگونه دانلود و آپلود دستی مدارک را حذف میکند؟ پاسخ سریع
در مدل جدید حسابرسی هوشمند، هدف این نیست که حسابرس فایل مشتری را از یک سامانه دانلود کند، روی رایانه ذخیره کند و دوباره برای یک ابزار هوش مصنوعی آپلود کند.
هدف این است که مدرک از همان لحظه دریافت در جریان کار حسابرسی باقی بماند و هوش مصنوعی در همان مسیر بتواند آن را شناسایی، کنترل و تحلیل کند.
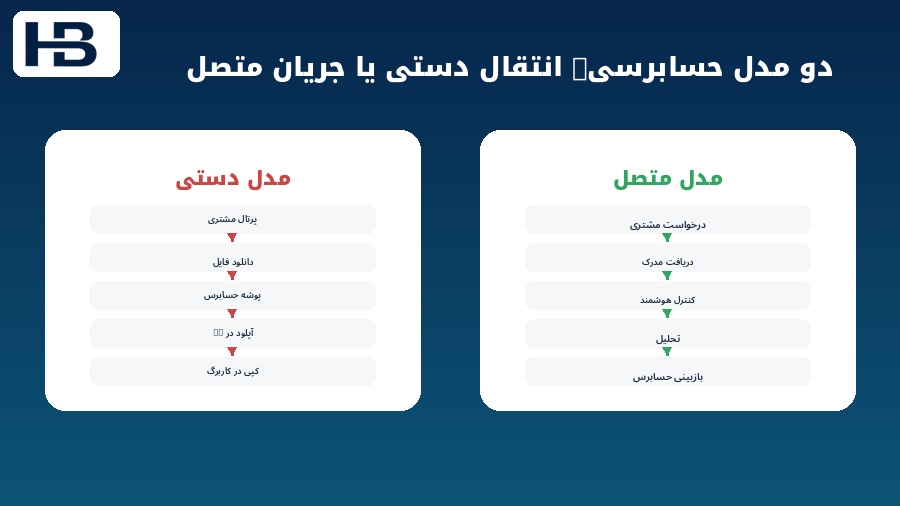
یعنی مسیر از این:
پرتال مشتری → دانلود → پوشه → آپلود در ابزار هوش مصنوعی → کپی نتیجه در کاربرگ
به این نزدیک میشود:
درخواست مدرک → دریافت مدرک → کنترل هوشمند → تحلیل → بازبینی حسابرس → کاربرگ
این تغییر شاید در ظاهر فقط حذف چند کلیک باشد، اما در عمل سه مشکل مهم را هدف میگیرد:
- جابهجایی دستی فایل؛
- ازدسترفتن اطلاعات زمینهای مدرک؛
- و استفاده تصادفی از نسخه اشتباه یا قدیمی.
مشکل اصلی کمبود هوش مصنوعی نیست؛ قطعشدن جریان کار است
فرض کنید مشتری گردش حساب بانکی را در پرتال بارگذاری کرده است.
در فرایند سنتی ممکن است حسابرس:
- فایل را دانلود کند؛
- نام آن را تغییر دهد؛
- در پوشه پرونده ذخیره کند؛
- برای تحلیل در ابزار دیگری بارگذاری کند؛
- خروجی را کپی کند؛
- و نتیجه را به کاربرگ منتقل کند.
هر انتقال یک نقطه خطاست.
ممکن است فایل اشتباه انتخاب شود، نسخه قبلی باقی بماند، دوره اشتباه بررسی شود یا مدرک در پوشه نامناسب ذخیره شود.
بنابراین حتی اگر ابزار هوش مصنوعی بسیار قدرتمند باشد، یک سؤال ساده باقی میماند:
هوش مصنوعی دقیقاً روی کدام فایل و کدام نسخه کار میکند؟
معماری متصل چه چیزی را تغییر میدهد؟
در معماری متصل، انسان دیگر نقش «پیک دیجیتال فایل» را در هر مرحله ندارد.
مدرک در همان محیطی که برای پرونده دریافت شده، به مراحل بعدی متصل میشود.
یک نمونه بینالمللی اعلامشده در ۱۵ سپتامبر ۲۰۲۶ دقیقاً در همین جهت طراحی شده است: اطلاعاتی که مشتری در محیط همکاری و تبادل مدارک تحویل میدهد، قرار است بدون انتقال دستی وارد محیط مدیریت پرونده و تحلیل مبتنی بر هوش مصنوعی شود.
این نمونه برای بستری اعلام شده که حدود ۸۰۰ هزار کاربر دارد و به گفته ارائهدهنده، ۶۰ درصد از ۲۰۰ مؤسسه بزرگ حسابداری از آن استفاده میکنند.
اهمیت این اعداد فقط بزرگی پلتفرم نیست؛ نشان میدهد بحث اتصال هوش مصنوعی به پرونده واقعی حسابرسی از مرحله آزمایش جداگانه عبور کرده و به معماری عملیاتی مؤسسات بزرگ نزدیک شده است.
از درخواست تا بازبینی یعنی چه؟
در حسابرسی، دریافت فایل پایان کار نیست.
فرض کنید حسابرس از مشتری خواسته است:
«صورتحساب بانک ملت اسفند را ارسال کنید.»
فایل پس از دریافت باید:
- شناسایی شود؛
- با درخواست مربوط تطبیق داده شود؛
- دوره آن کنترل شود؛
- کاملبودن آن بررسی شود؛
- و در نهایت به پرونده و کاربرگ مناسب متصل شود.
پس جریان واقعی چنین است:
درخواست → دریافت → اعتبارسنجی → تحلیل → بازبینی
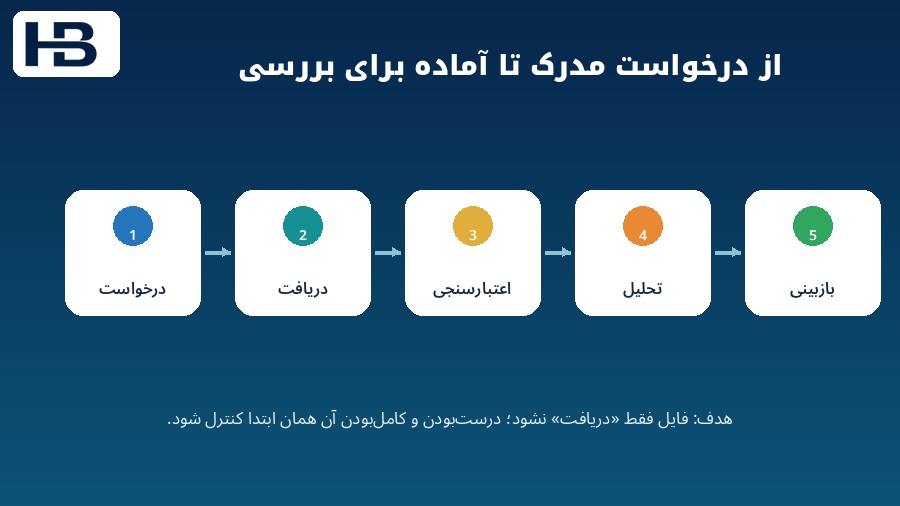
هرچه این زنجیره پیوستهتر باشد، نیاز به کار دستی کمتر و احتمال گمشدن اطلاعات زمینهای پایینتر میشود.
چرا هوش مصنوعی بدون اطلاعات زمینهای مدرک ناقص است؟
فرض کنید فقط یک فایل با نام bank.pdf به یک ابزار هوش مصنوعی داده شود.
ممکن است محتوای فایل را بخواند، اما از خود فایل لزوماً نمیداند:
- مربوط به کدام مشتری است؛
- برای کدام حساب بانکی است؛
- چه دورهای درخواست شده؛
- چه کسی فایل را ارسال کرده؛
- پاسخ به کدام درخواست بوده؛
- و آیا نسخه نهایی است یا نسخه قبلی.
این اطلاعات، زمینه مدرک هستند.
اگر فایل از سیستم اصلی جدا شود، بخشی از این زمینه ممکن است از بین برود.
![اطلاعات زمینهای مدرک حسابرسی شامل مشتری پرونده دوره درخواست ارسال کننده و نسخه] به همین دلیل تفاوت بزرگی وجود دارد بین](/img/article-img/images/insideDesc/541550fa145c471e8506227df8ec3bc9.jpg)
هوش مصنوعی روی یک فایل
و:
هوش مصنوعی داخل جریان واقعی حسابرسی
مثال عملی؛ صورتحساب بانکی
فرض کنید حسابرس صورتحساب بانک ملت از اول تا پایان اسفند را درخواست کرده است.
مشتری فایلی بارگذاری میکند.
عامل هوشمند میتواند قبل از اینکه حسابرس فایل را باز کند بررسی کند:
- بانک درست است؟
- شماره حساب با پرونده تطبیق دارد؟
- دوره زمانی کامل است؟
- همه صفحات وجود دارند؟
- فایل همان چیزی است که درخواست شده؟
- آیا نسخه جدیدتری وجود دارد؟
اگر پاسخها قابل قبول باشند، مدرک وارد مرحله بعد میشود.
اگر نه، پرونده به وضعیت استثنا میرود.
از دریافت مدرک به اعتبارسنجی مدرک
در پرتالهای قدیمی سؤال اصلی این بود:
آیا مشتری فایل فرستاده است؟
اما سؤال حرفهایتر این است:
آیا مشتری مدرک درست را فرستاده است؟
وجود یک پیوست بهتنهایی به معنی تکمیل درخواست نیست.
برای مثال اگر درخواست مربوط به قرارداد تسهیلات سال جاری باشد و مشتری قرارداد سال قبل را بارگذاری کند، سیستم نباید صرفاً چون یک فایل دریافت شده وضعیت را «تکمیلشده» نشان دهد.
وضعیت واقعی میتواند چنین باشد:
مدرک دریافت شد؛ درخواست هنوز برآورده نشده است.
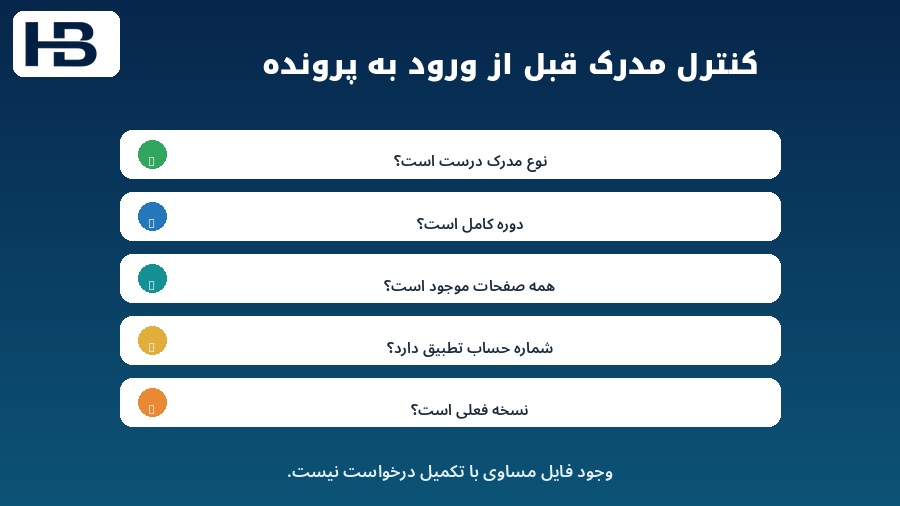
این نوع کنترل میتواند رفتوبرگشت با مشتری را بسیار زودتر شروع کند و از کشف نقص چند روز بعد جلوگیری کند.
هوش مصنوعی میتواند مدرک گمشده را هم پیدا کند
فرض کنید برای یک حساب بانکی باید ۱۲ صورتحساب ماهانه دریافت شود.
پرونده فقط ۱۱ فایل دارد.
عامل هوشمند میتواند تشخیص دهد:
صورتحساب مرداد موجود نیست.
این کشف بسیار ارزشمندتر از آن است که حسابرس هنگام مغایرتگیری تازه متوجه شود یک ماه کامل وجود ندارد.
همین منطق برای قراردادها، فاکتورها، لیست حقوق، تأییدیهها و سایر مدارک پرونده نیز قابل استفاده است.
نام فایل مهم است؛ اما فراداده مهمتر است
مشتری ممکن است فایلهایی با نامهایی مثل scan001.pdf یا final2.pdf ارسال کند.
هوش مصنوعی میتواند نام قابل فهمتری پیشنهاد دهد، اما ارزش اصلی در این است که همراه سند، اطلاعات ساختاریافته ذخیره شود:
- نوع مدرک؛
- دوره؛
- شرکت یا واحد مربوط؛
- حساب مرتبط؛
- شناسه درخواست؛
- نسخه؛
- وضعیت بررسی.
این فرادادهها باعث میشوند عاملهای هوشمند بعداً مدرک را دقیقتر پیدا و استفاده کنند.
ردپای مدرک؛ هوش مصنوعی باید بداند سند از کجا آمده است
اگر هوش مصنوعی درباره یک حساب نتیجهگیری کند، حسابرس باید بتواند بپرسد:
- این نتیجه بر اساس کدام مدرک بود؟
- چه کسی آن را ارسال کرد؟
- چه زمانی دریافت شد؟
- مربوط به کدام درخواست بود؟
- آیا نسخه جدیدتری بعداً رسیده است؟
این همان ردپای مدرک است.
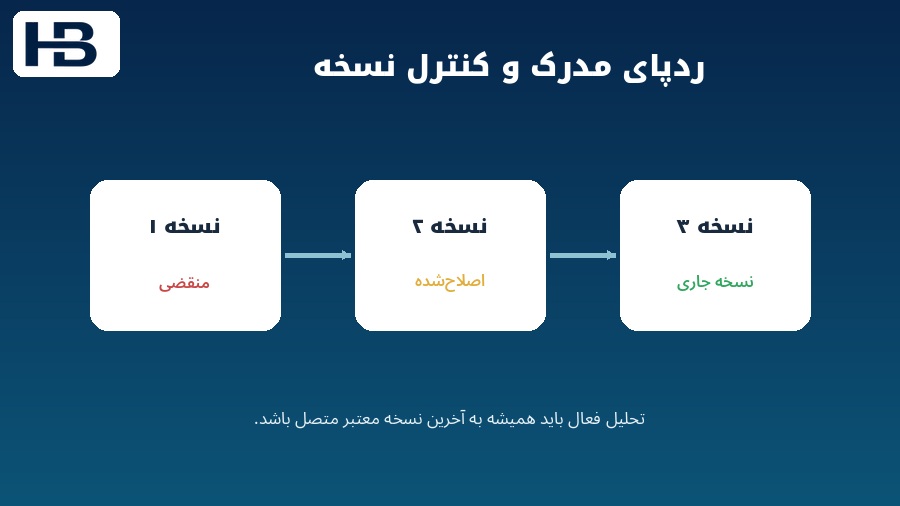
فرض کنید مشتری ابتدا نسخه اشتباه یک فایل را ارسال کند و دو روز بعد نسخه صحیح را جایگزین کند.
سیستم باید بداند:
نسخه ۱ → منقضی
نسخه ۲ → جاری
و تحلیل فعال باید به نسخه معتبر متصل باشد.
در محیط حرفهای، پاسخ بسیار دقیق بر اساس مدرک قدیمی همچنان پاسخ اشتباه است.
به همین دلیل کنترل نسخه، بخشی از حاکمیت هوش مصنوعی در حسابرسی است.
اتصال مستقیم میتواند ریسک امنیتی جابهجایی فایل را کم کند
در مدل غیرمتصل، کارکنان ممکن است فایل مشتری را دانلود کنند، روی دسکتاپ نگه دارند، در پوشههای مختلف کپی کنند و دوباره در ابزار دیگری بارگذاری کنند.
هر نسخه اضافی یک سطح جدید از ریسک ایجاد میکند.
وقتی تحلیل هوش مصنوعی در محیط کنترلشده و متصل انجام شود، نیاز به کپی و جابهجایی غیرضروری فایل کاهش مییابد.
اما اتصال بیشتر نباید به معنی دسترسی بیشتر از حد لازم باشد.
دسترسی هوش مصنوعی باید همان محدودیت پرونده را رعایت کند
اگر یک کاربر مجاز به دیدن یک پرونده نیست، عامل هوشمندی که از طرف او کار میکند هم نباید به آن پرونده دسترسی داشته باشد.
بنابراین در معماری حرفهای باید مشخص باشد:
- چه کاربری مجاز است؛
- به کدام پرونده؛
- به کدام نوع مدرک؛
- برای چه عملیاتی؛
- و با چه سطح اختیاری.
اتصال سیستمها به معنی دسترسی آزاد هوش مصنوعی به تمام اسناد نیست.
در کنار این موضوع، تاریخچه کامل عملیات هم باید ثبت شود:
- درخواست چه زمانی ایجاد شد؟
- مشتری چه زمانی پاسخ داد؟
- کدام فایل ارسال شد؟
- عامل هوشمند چه کاری انجام داد؟
- حسابرس چه چیزی را تغییر داد؟
- چه کسی تأیید نهایی کرد؟
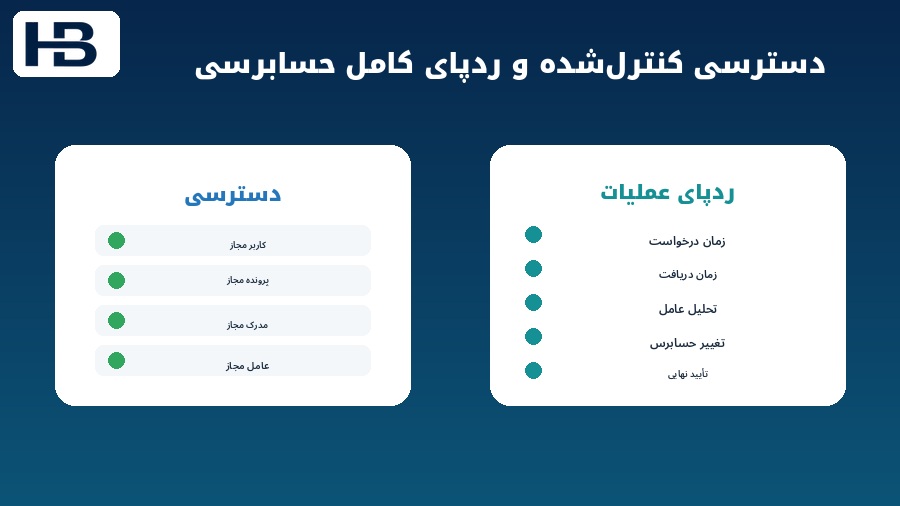
این همان چیزی است که باعث میشود استفاده از هوش مصنوعی در پرونده حسابرسی بعداً قابل توضیح و بازسازی باشد.
تفاوت هوش مصنوعی متصل با روش کپی و پیست چیست؟
روش کپی و پیست
حسابرس فایل را دانلود میکند، ابزار گفتوگویی را باز میکند، فایل را بارگذاری میکند، دستور مینویسد، جواب را کپی میکند و نتیجه را در کاربرگ میگذارد.
روش متصل
عامل هوشمند از قبل میداند:
- مدرک برای کدام مشتری است؛
- برای چه دورهای است؛
- پاسخ کدام درخواست است؛
- نسخه معتبر کدام است؛
- و نتیجه باید در کدام بخش پرونده قرار گیرد.
مدل دوم از نظر عملیاتی بسیار مهمتر است.
در مقاله حسابرسی هوشمند از درخواست مدارک تا کاربرگ نیز همین مسیر از زاویه حذف کارهای کپیکاری و آمادهسازی کاربرگ بررسی شده است.
آینده هوش مصنوعی حرفهای بیشتر درباره اتصال است تا چت
در موج اول هوش مصنوعی سؤال اصلی این بود:
مدل چقدر باهوش است؟
اما در محیط حرفهای، سؤالهای مهمتری مطرح میشوند:
- مدل به چه دادهای دسترسی دارد؟
- این داده مربوط به کدام مشتری و دوره است؟
- نسخه معتبر کدام است؟
- کاربر چه مجوزی دارد؟
- خروجی بر اساس چه مدرکی تولید شده؟
- چه کسی آن را بازبینی کرده؟
یک مدل بسیار قدرتمند بدون داده درست، زمینه درست و سطح دسترسی درست نمیتواند خروجی حسابرسی قابل اتکایی تولید کند.
این جهتگیری با موضوع حافظه سازمانی برای هوش مصنوعی مالی نیز مرتبط است؛ چون سیستم باید بداند کدام نسخه و کدام تصمیم معتبر است و نباید هر بار از صفر شروع کند.
میخواهید مقالات کاربردی هوش مصنوعی در حسابداری و حسابرسی را دنبال کنید؟
با عضویت در حسابداران برتر، دسترسی شما به پنل کاربری، مقالات تخصصی و محتوای آموزشی سایت منظمتر میشود.
از خودکارسازی یک کار به خودکارسازی یک نتیجه
در نسل قبلی اتوماسیون، هدف معمولاً یک کار کوچک بود:
فایل PDF را بخوان.
اما نسل جدید میتواند هدف بزرگتری داشته باشد:
«این درخواست مدرک را تا مرحله آماده برای بازبینی جلو ببر.»
در این حالت عامل هوشمند ممکن است:
- فایل را دریافت کند؛
- نوع آن را تشخیص دهد؛
- دوره را کنترل کند؛
- کاملبودن را بررسی کند؛
- اطلاعات اصلی را استخراج کند؛
- تحلیل اولیه انجام دهد؛
- و پرونده را برای حسابرس آماده کند.
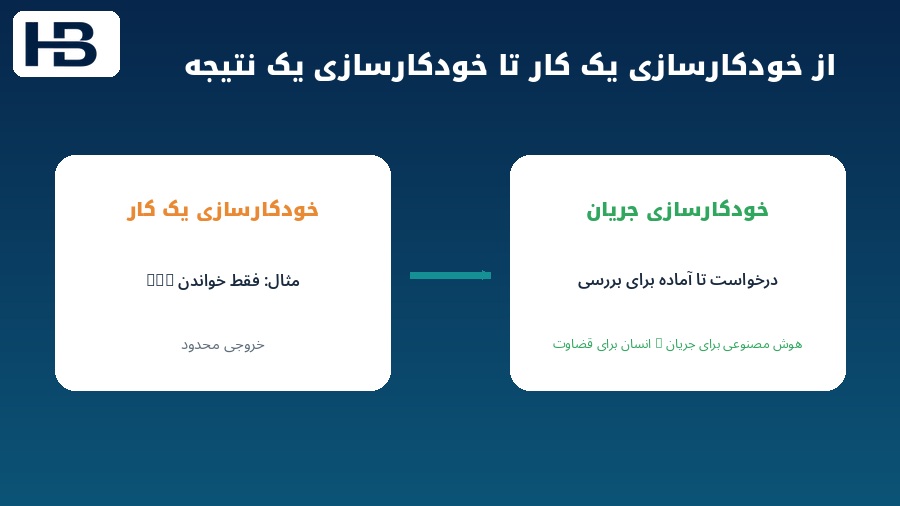
این همان حرکت از خودکارسازی وظیفه به خودکارسازی جریان کار است.
انسان کجا وارد میشود؟
هرچه هوش مصنوعی بیشتر در جریان کار قرار گیرد، نقش انسان حذف نمیشود؛ محل ورود انسان تغییر میکند.
حسابرس باید زمانی وارد شود که:
- مدرک مبهم است؛
- استثنا وجود دارد؛
- شواهد کافی نیست؛
- موضوع بااهمیت است؛
- یا قضاوت حرفهای لازم است.
مدل مناسب را میتوان اینطور خلاصه کرد:
هوش مصنوعی برای جریان کار؛ انسان برای قضاوت
این همان تغییری است که در بخشهای دیگر حسابداری هم دیده میشود. مثلاً در حسابهای پرداختنی چیست؟ خودکارسازی بیش از ۸۰٪ فاکتورها با هوش مصنوعی نیز ماشین حجم کار عادی را مدیریت میکند و انسان روی موارد استثنایی تمرکز میکند.
حسابرس دیگر نباید حملکننده دیجیتال فایل باشد
بخش زیادی از زمان متخصص مالی ممکن است صرف جابهجایی اطلاعات شود:
ایمیل → پوشه → اکسل → نرمافزار → پرتال → پرونده → ابزار هوش مصنوعی
این کار ارزش حرفهای کمی دارد.
ارزش حسابرس در مواردی مثل این است:
- آیا مدرک کافی است؟
- آیا شواهد با ادعا سازگارند؟
- آیا استثنا مهم است؟
- آیا نتیجه قابل اتکاست؟
- آیا اثر موضوع بااهمیت است؟
- آیا نیاز به رسیدگی بیشتر وجود دارد؟
اتصال سیستمها میتواند زمان را از «حمل اطلاعات» به «قضاوت حرفهای» منتقل کند.
این تحول برای مؤسسات و تیمهای ایرانی چه معنایی دارد؟
نمونهای که این مقاله از آن الهام گرفته، مربوط به یک اتصال بینالمللی است و به معنی در دسترسبودن همان محصول یا زیرساخت در ایران نیست.
اما اصل معماری برای شرکتهای نرمافزاری، مؤسسات حسابرسی و تیمهای مالی ایرانی قابل توجه است:
بهجای اینکه هر ابزار هوش مصنوعی جزیرهای جدا باشد، باید بتواند با رعایت دسترسی به همان پروندهای وصل شود که اطلاعات معتبر در آن نگهداری میشوند.
برای طراحی چنین سیستمی حداقل این مفاهیم مهماند:
- جریان کار؛
- فراداده؛
- کنترل نسخه؛
- ردپای مدرک؛
- سطح دسترسی؛
- سابقه عملیات؛
- و بازبینی انسانی.
در حسابداران برتر نیز پرداختن به هوش مصنوعی حرفهای حسابداری از همین زاویه اهمیت دارد: آینده فقط یادگیری نوشتن دستور برای چتبات نیست؛ حسابدار باید بفهمد داده معتبر چگونه وارد یک جریان کنترلشده میشود.
یک چکلیست برای ارزیابی سیستم حسابرسی هوشمند
اگر قرار است نرمافزار یا فرایندی برای اتصال هوش مصنوعی به پرونده حسابرسی طراحی یا خریداری شود، این سؤالها مفیدند:
- آیا مدرک بدون دانلود و آپلود مجدد وارد تحلیل میشود؟
- آیا مشخص است فایل پاسخ کدام درخواست است؟
- آیا دوره و نوع مدرک قابل کنترل است؟
- آیا فایل ناقص یا اشتباه شناسایی میشود؟
- آیا نسخه قدیمی و نسخه جاری از هم تفکیک میشوند؟
- آیا عامل فقط به مدارکی دسترسی دارد که کاربر مجاز است ببیند؟
- آیا منبع هر نتیجه قابل ردیابی است؟
- آیا تغییر حسابرس و نتیجه نهایی ثبت میشود؟
- آیا پرونده میتواند نشان دهد هوش مصنوعی چه کاری انجام داده است؟
- آیا موارد مبهم و بااهمیت به انسان ارجاع میشوند؟
اگر پاسخ چند مورد از این سؤالها «نه» باشد، احتمالاً هنوز با یک ابزار هوش مصنوعی جداگانه روبهرو هستیم، نه یک جریان حسابرسی هوشمند واقعی.
سؤالات متداول
اتصال مستقیم هوش مصنوعی به پرونده حسابرسی یعنی چه؟
یعنی مدرکی که مشتری در محیط کنترلشده تحویل میدهد، بدون دانلود و آپلود دستی مکرر بتواند در همان جریان برای کنترل، تحلیل و بازبینی استفاده شود.
آیا این مدل به معنی حذف حسابرس است؟
خیر. هدف حذف کارهای انتقال و کنترل تکراری است. قضاوت حرفهای، رسیدگی به استثناها و تأیید موارد بااهمیت همچنان به حسابرس نیاز دارد.
چرا زمینه مدرک مهم است؟
چون خود فایل بهتنهایی ممکن است نشان ندهد مربوط به کدام مشتری، درخواست، دوره یا نسخه است. بدون این اطلاعات، تحلیل روی فایل اشتباه ممکن است کاملاً منطقی ولی نادرست باشد.
کنترل نسخه چه نقشی دارد؟
سیستم باید بداند کدام نسخه قدیمی و کدام نسخه فعلی است. تحلیل فعال باید به آخرین نسخه معتبر متصل باشد.
آیا اتصال بیشتر، امنیت را کاهش میدهد؟
اگر درست طراحی شود، میتواند جابهجایی غیرضروری فایل را کم کند؛ اما فقط به شرطی که دسترسی کاربران و عاملهای هوشمند دقیقاً کنترل شود.
آیا هوش مصنوعی میتواند تشخیص دهد مدرک ناقص است؟
در بسیاری از موارد بله؛ مثلاً دوره اشتباه، صفحات ناقص، مدرک نامرتبط یا ماه گمشده را میتوان برای بررسی علامتگذاری کرد.
تفاوت خودکارسازی وظیفه با خودکارسازی جریان چیست؟
در خودکارسازی وظیفه، فقط یک کار مثل استخراج متن انجام میشود. در خودکارسازی جریان، سیستم یک نتیجه کاملتر مثل «درخواست آماده برای بازبینی» را از چند مرحله به هم متصل میکند.
جمعبندی
تحول مهم هوش مصنوعی در حسابرسی فقط باهوشترشدن مدلها نیست.
تغییر اصلی این است که هوش مصنوعی از یک ابزار جداگانه خارج شود و در جریان واقعی پرونده قرار بگیرد.
مدل آینده بیشتر شبیه این است:
درخواست → مدرک → کنترل → تحلیل → بازبینی → کاربرگ
بدون اینکه حسابرس در هر مرحله مجبور باشد فایل را دانلود، نامگذاری، ذخیره و دوباره بارگذاری کند.
وقتی زمینه مدرک، نسخه، دسترسی و ردپای عملیات حفظ شوند، هوش مصنوعی نه فقط سریعتر، بلکه قابلکنترلتر و قابلردیابیتر وارد حسابرسی میشود.
و شاید مهمترین تغییر این باشد:
حسابرس کمتر زمان خود را صرف جابهجایی فایل میکند و بیشتر زمان خود را صرف کاری میکند که واقعاً ارزش حرفهای دارد؛ بررسی شواهد و قضاوت.
اگر میخواهید این مسیر را در مقالات بعدی هم دنبال کنید
با عضویت در حسابداران برتر به پنل کاربری و مسیر دسترسی منظمتر به مقالات و آموزشهای تخصصی حسابداری دسترسی خواهید داشت.
مقالات مرتبط
حافظه سازمانی برای هوش مصنوعی مالی چیست؟ چرا AI نباید هر بار از صفر شروع کند
حسابرسی هوشمند از درخواست مدارک تا کاربرگ؛ پایان کپیکاری در پرونده حسابرسی
حسابهای پرداختنی چیست؟ خودکارسازی بیش از ۸۰٪ فاکتورها با هوش مصنوعی
بستن حسابها با هوش مصنوعی چیست؟ از بستن پایان ماه تا بستن صفرروزه